どうもTORAです。
仕事で、GitHub CopilotのAIエージェントを使い、Javaの製造と単体テストを進める仕組みを作りました。コードを書かせる手順に、静的解析やJUnitのテスト実行、それぞれの結果を記録する作業まで組み込みました。
今回の現場は、品質ゲートのあるウォーターフォール開発です。品質ゲートというのは、工程の区切りで成果物や品質の状況を確認し、次の工程へ進めるか判断する場のことです。この現場では、ソースのステップ数やテストケース数、不具合件数などを品質報告書にまとめます。AIエージェントを使う開発も、その評価に必要な材料を揃えながら進めました。
品質の記録も、開発手順に入れる
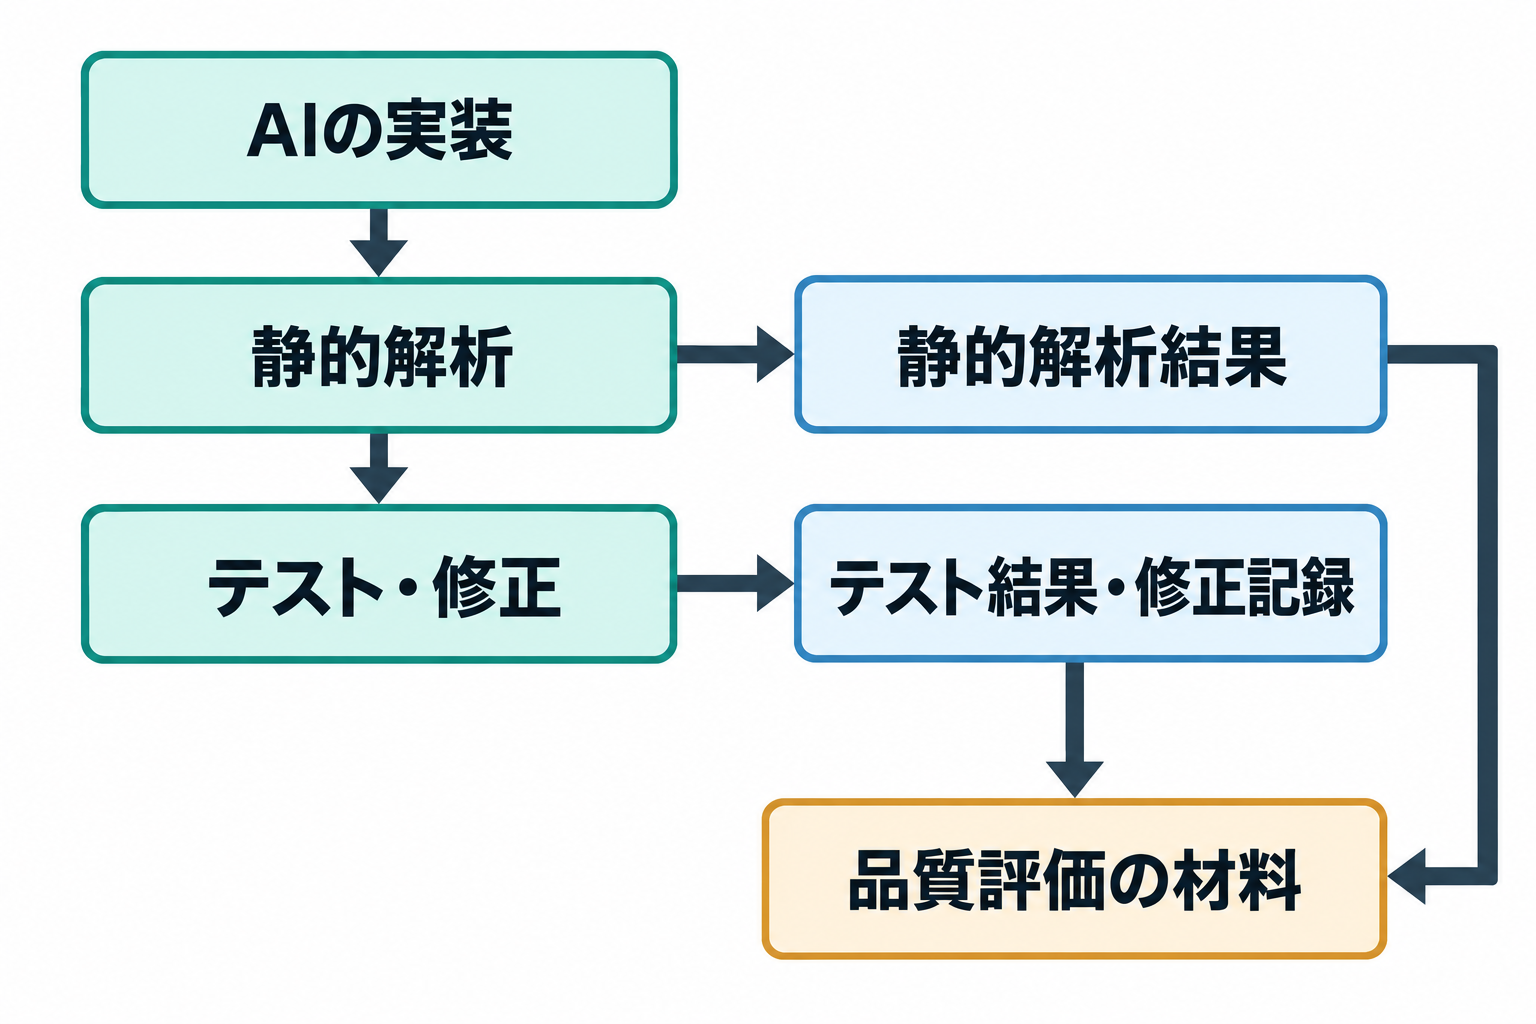
エージェントに任せると、実装して、テストを回して、落ちたら直してまた回す、という作業をどんどん進めてくれます。この作業の途中で発生する問題と対処も、品質評価に使う情報です。テストの最終結果に加えて、修正の経緯も残す手順を作りました。
具体的には、情報を取る作業をエージェント向けの手順に書き込みました。手順を書いたのはInstructionsです。InstructionsはGitHub Copilotのエージェントが作業するときに読み込む指示ファイルで、作業ルールを書いておけます。ここに、JUnitの結果は機能単位のフォルダへ出す、静的解析とテストの結果は決まった場所へ出す、といった決まりを書いておきました。
ここは、エンタープライズの開発をずっとやってきた経験がそのまま使えたところだと思ってます。自分で言うのもあれなんですけど、品質ゲートで何を聞かれて、その数字が報告書でどう使われるかを知っていました。だから、AIの作業を決める段階で、どこで何を出させておくかを決められました。設計書についても、人向けとAI向けの資料を分けました。人に納めるExcelの設計書とは別に、Microsoft 365 CopilotでSPECSというMarkdownに変換したものを作り、それをエージェントの入力にしました。
開発の途中で、品質記録を残す
何を確かめたテストなのか、一覧で読めるようにする
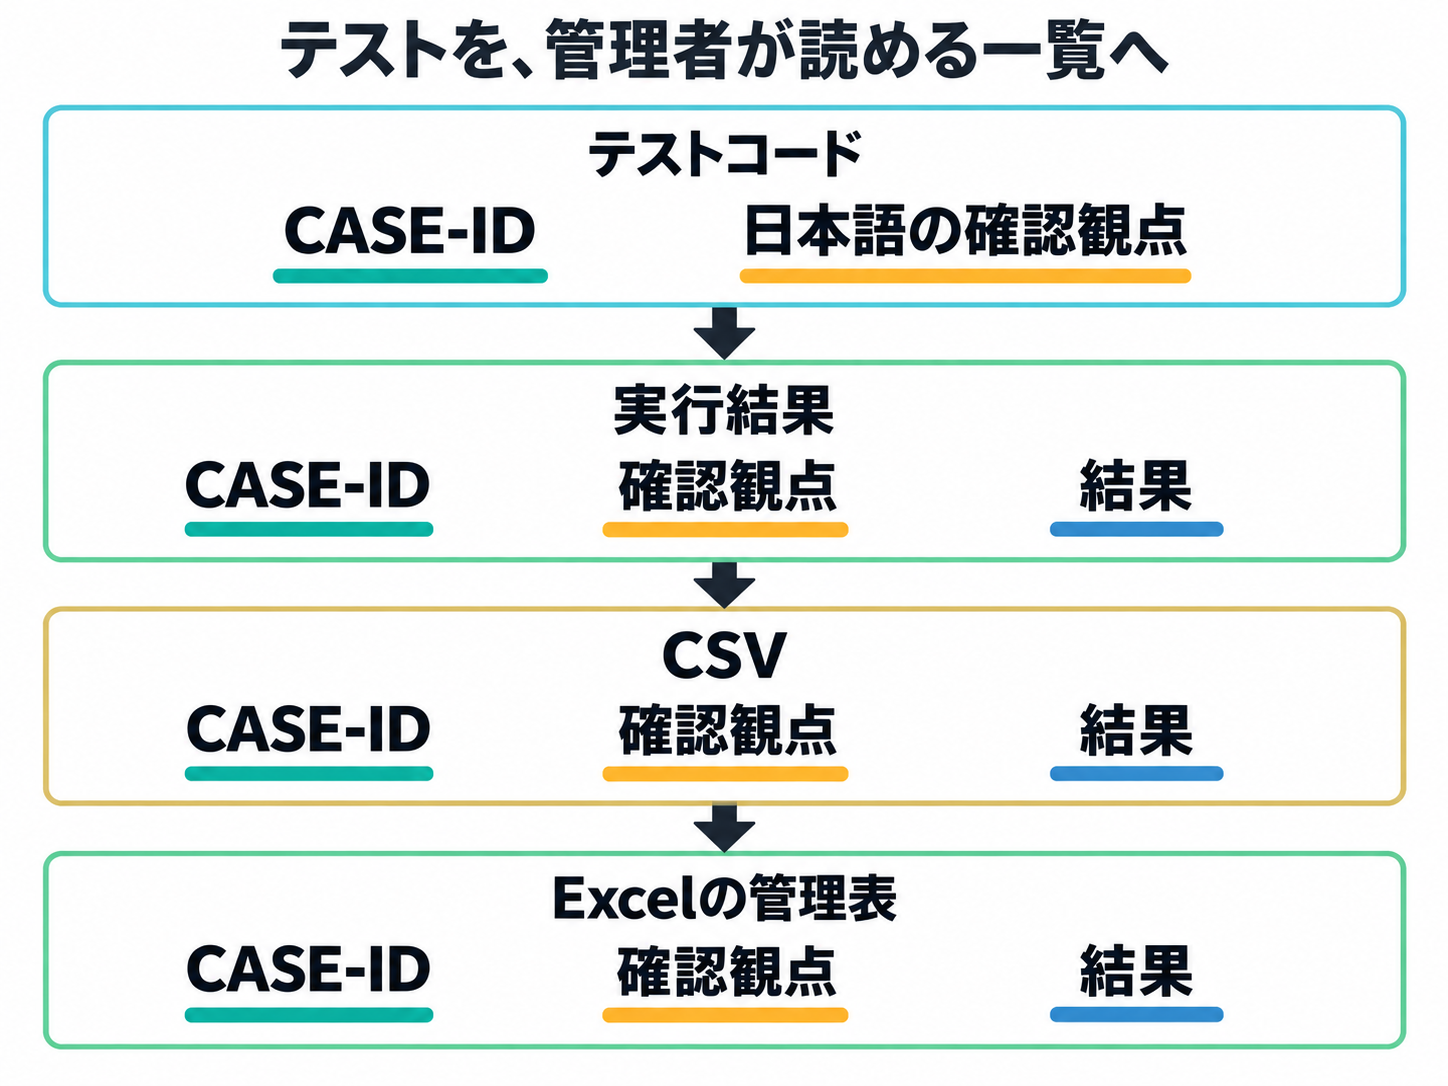
管理表とテストコードを対応させるために使ったのが、CASE-IDというテストケースの管理番号です。エージェントには、テストを書くときにJUnitのDisplayNameなどへCASE-IDを入れ、「このテストで何を確認するか」を日本語で書かせました。DisplayNameは、テストに表示名を付けるためのJUnitの機能です。そこからCASE-IDと説明を取り出して管理表と対応させる部分は、自分たちで作りました。
テスト結果は、PowerShellのスクリプトで品質評価用のCSVに変換します。列はCASE-ID、対象のテストクラス、確認観点、結果(PASS、FAIL、ERROR、SKIP)、実行時間、失敗メッセージ、検出日時です。ファイル名には日時や機能、担当者を識別する情報を入れて、いつ誰がどの機能で回した結果か見分けられるようにしました。
このCSVをExcelに貼ると、開発の細かいところを知らない管理者でも、どんなケースがあって結果がどうだったかを一覧で確認できます。品質の判断をする人が、必ずしもコードを読む人ではないんですよね。なので、技術に詳しくない人でも判断できるように、出力を今までの説明の形に寄せました。
落ちたテストも残す
失敗したテストは、別のスクリプトで障害管理用のCSVに落とします。静的解析のほうも、Checkstyle、SpotBugs、PMDの結果を一つのCSVにまとめるようにしました。それと、修正に入る前に原因と修正内容を記録する手順にしました。
原因の分類は、もともと不具合管理でやってきたものです。その従来の分類に、AI特有のものを足しました。存在しないAPIを使っていた、Instructionsのルールを守っていなかった、といったものを、普通の実装ミスと分けて見られるようにしたかったからです。
ただ、ここで集めるのは、品質評価の基礎になる情報です。テストが落ちた件数や静的解析の指摘数を、正式な不具合件数として扱うには、原因や管理上の数え方を確認する必要があります。同じ原因で複数のテストが落ちることもあります。直して回し直せば、同じ失敗がまた記録されることもあります。記録を残しておけば、何が起きていたのかを確認しながら評価できます。
人の確認を挟んで、手順を見直す
最初に組んだのは、実装、静的解析、修正、テスト、記録、再テストまでを、エージェントが一続きで回すループでした。
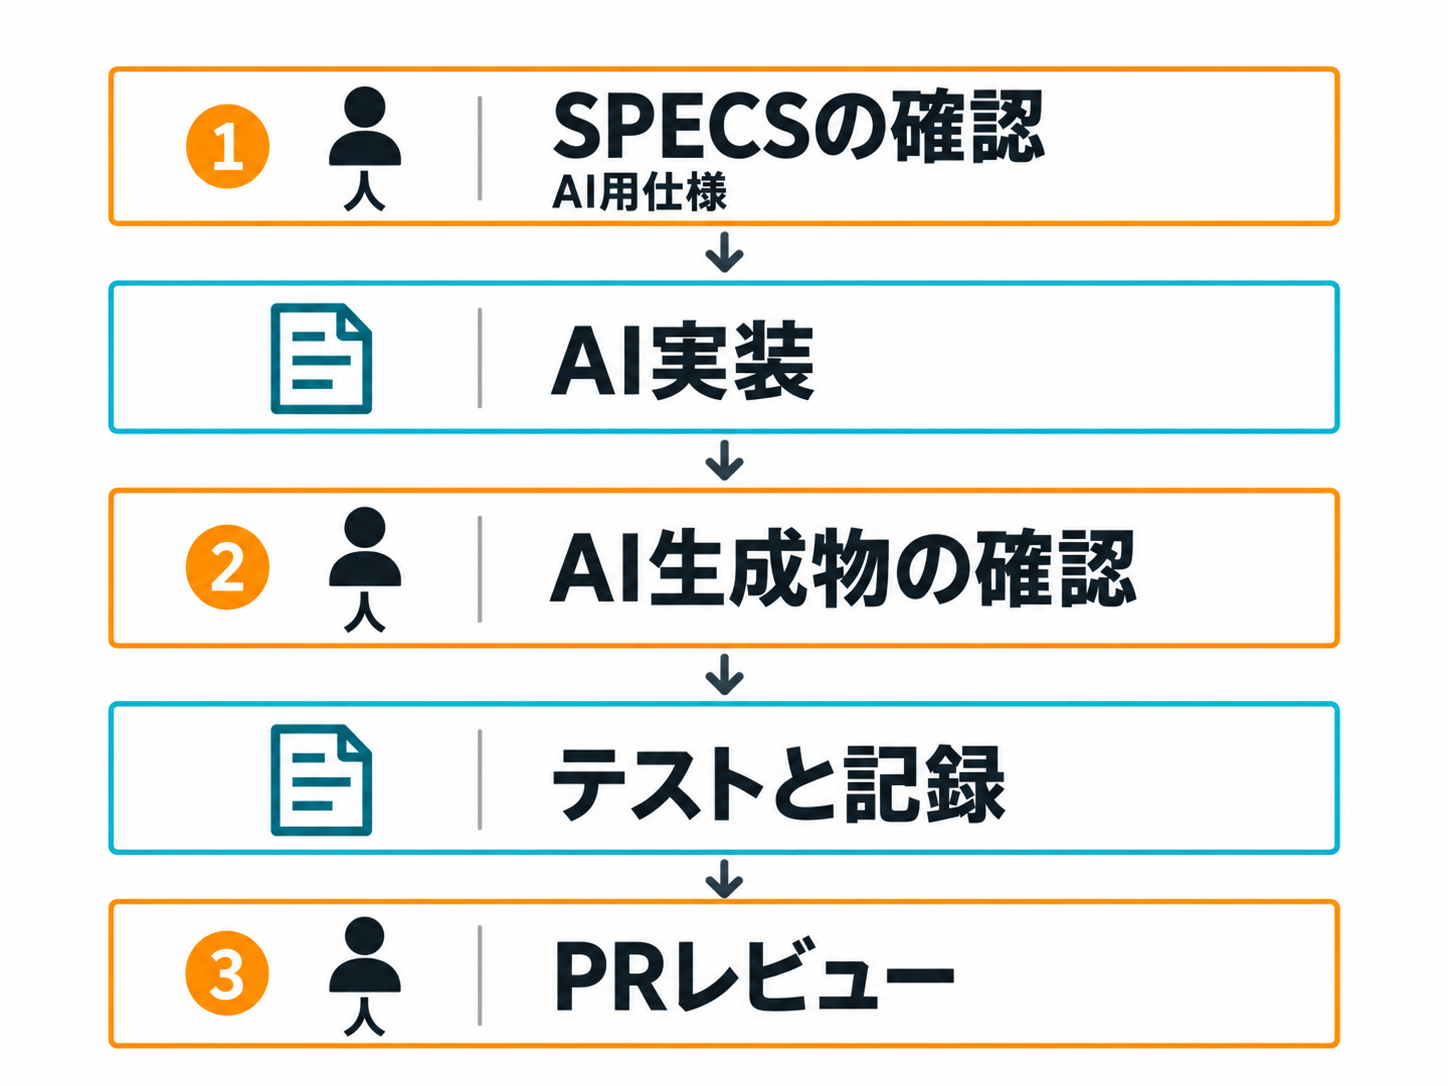
そこから手順を変えています。実装とテストを分けて、その間に人のレビューを挟む形にしました。静的解析で出た指摘も、単純な修正は人がやる方針にしました。人が見るのは、SPECSの確認、AIが作ったものの確認、PRレビューのところです。
人が確認する3つの場所
従来の品質指標に加えて、AIを使う開発で何を見るかは、実務を通して見直していく部分です。今回作った仕組みでは、テストの内容と結果に加えて、修正の経緯も残すようにしました。