どうもTORAです。
Anthropic「How the Claude Code team does code review」(2026年10月15日)という記事が公開されました。Claude Codeを開発しているチームが、AIエージェントが大量に書くコードをどうレビューしているかを紹介したものです。
僕の現場はウォーターフォールの新規システム開発で、今回の開発ではそこにAI駆動開発を取り入れました。開発スタイルはClaude Codeチームとはかなり違います。それでも、自分の現場と比べながら読むと、考え方が近いところがいくつかありました。この記事では前半でAnthropicの記事の中身を解説して、後半で僕の現場のやり方を、共通点とこの現場向けにした工夫に分けて紹介します。
Claude Codeチームは「人の時間」を基準にレビューを組み直した
記事によると、Claude Codeのコードはおよそ9割をClaudeが書いているそうです。6月から9月にかけて、マージされたプルリクエストは2倍以上に増えました。その一方で、取り消し(revert)が必要になった割合は4割以上下がったと書かれています。
プルリクエスト(PR)は、変更したコードをチームに確認してもらい、取り込んでもらうための依頼の仕組みです。エージェントが書く変更がこれだけ増えると、人が一行ずつ読むレビューは非常に難しいと記事にはあります。そこで彼らは、レビューの目的から考え直しています。
記事ではコードレビューの役割を、出荷前に問題を見つけて直すことと、チームでコードの理解を共有することの二つに分けています。そのうえで「人間がコードを読んだか」はあまり正確な目安ではないとしています。代わりに問うのは「この変更で何が起こり得て、それを見つけるのに自動チェックと人のどちらが向いているか」です。
目標も具体的です。多くのPRを、人の関与を最大1人(作者本人でもいい)でマージし、それで取り消しや障害が増えないこと。PRあたりの人の承認数やコメント数、人を待っている時間を測り、取り消し率と障害率をガードレールとして見ています。レビューの時間を減らしても、壊れたものを直す時間が増えたら意味がない、という考え方です。
チェックを何層も重ねる
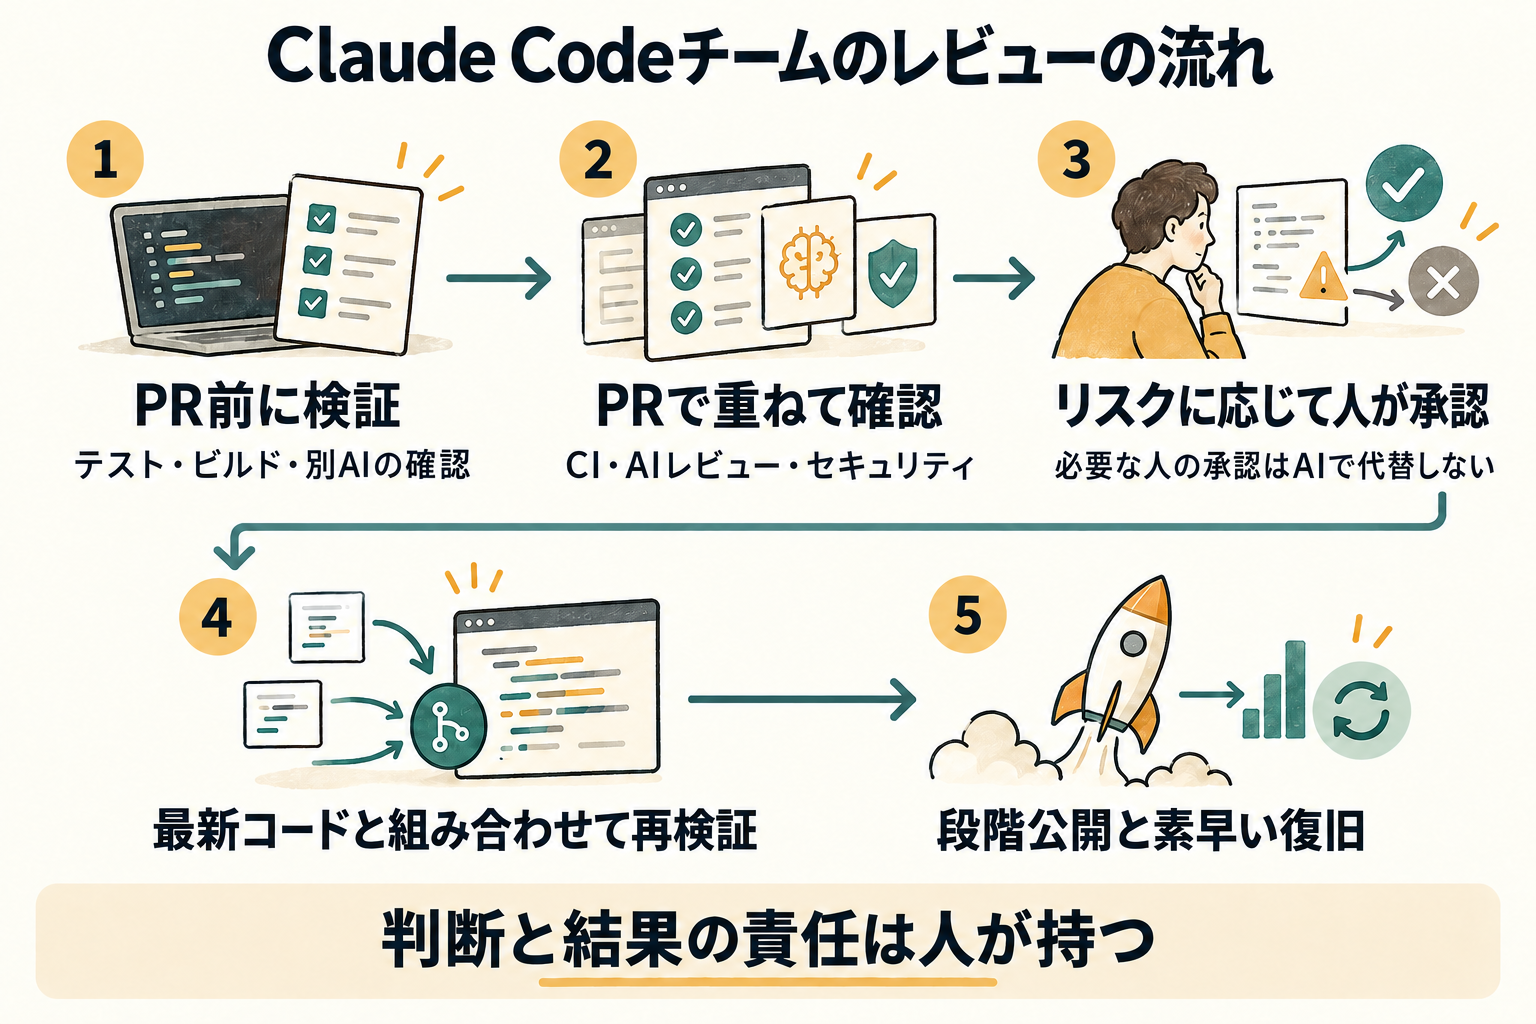
具体的な流れは、レビューを最後の関門にするのではなく、何層ものチェックを重ねる形になっています。
PRを出す前に、Claudeがテスト、ビルド、lint(書き方の誤りや規約違反を機械的に見つけるツール)を実行して、「できました」と言う代わりに実行結果を見せます。さらに別のエージェントが、新しいコンテキストで差分をレビューします。
このときAIに渡す前提として、CLAUDE.mdとREVIEW.mdというファイルが紹介されています。CLAUDE.mdはプロジェクトの構成や規約、目的をClaudeに伝えるファイルで、REVIEW.mdはコードの担当者がレビューで見てほしい点を書くファイルです。自動レビューで同じ指摘が続いたら、指摘元のスキルやlintのルール、こうした指示ファイルのほうを直すという話も記事にあります。
PRが出たら、必須のCI(変更のたびにビルドやテストを自動で走らせる仕組み)、AIによるコードレビュー、セキュリティレビューが走ります。AIレビューでは複数のエージェントが並行してバグを探し、別のエージェント群が各指摘を本物かどうか投票で確かめ、残ったものだけが重要度順にコメントされます。指摘には必ず、直すか、理由を書いて閉じるかで応える決まりです。
人の承認はリスクで変わります。ドキュメント修正のような低リスクの変更は、自動レビューとセキュリティチェックが通れば人の承認は不要で、通常の変更は1人、最もリスクの高いコードは2人です。リスクは作者ではなく変更内容から分類器が判定し、軽い経路を使えるのは信頼済みの作者だけ。エージェントの承認は、人の承認が必要な枠を埋められません。エージェントに指示した人も、自分で書いたのと同じように必須レビュアーに数えられます。
マージ後の新しい振る舞いは、通常はフラグの裏で社内利用から始めて段階的に公開し、問題があればフラグを切るか取り消します。障害の振り返りでは「どの層で止めるべきだったか」を問うそうです。
レビューするAIの側も改善の対象です。過去に障害や取り消しを起こしたPRを集めて評価用のデータにし、毎日それに対してレビュアーを走らせています。AI同士で修正とレビューを延々と繰り返す問題も書かれていて、あるPRは一晩で50回以上往復したそうです。その対策として、3往復したら作者にやり方そのものの見直しを求める、数回目以降は新しい差分だけを見る、といったルールを入れています。
人に残す判断は、そもそも作るべきか、リスクの高いコード、他の人が真似する設計、テスト結果などの証拠を読むこと、結果への責任、と整理されています。「チェックが何を見逃すか説明できないなら、簡単な承認ではなくちゃんとしたレビューを頼む」という趣旨の一文もあります。
設計書をAI向けの仕様に変換するところから始めた
ここからは僕の現場の話です。
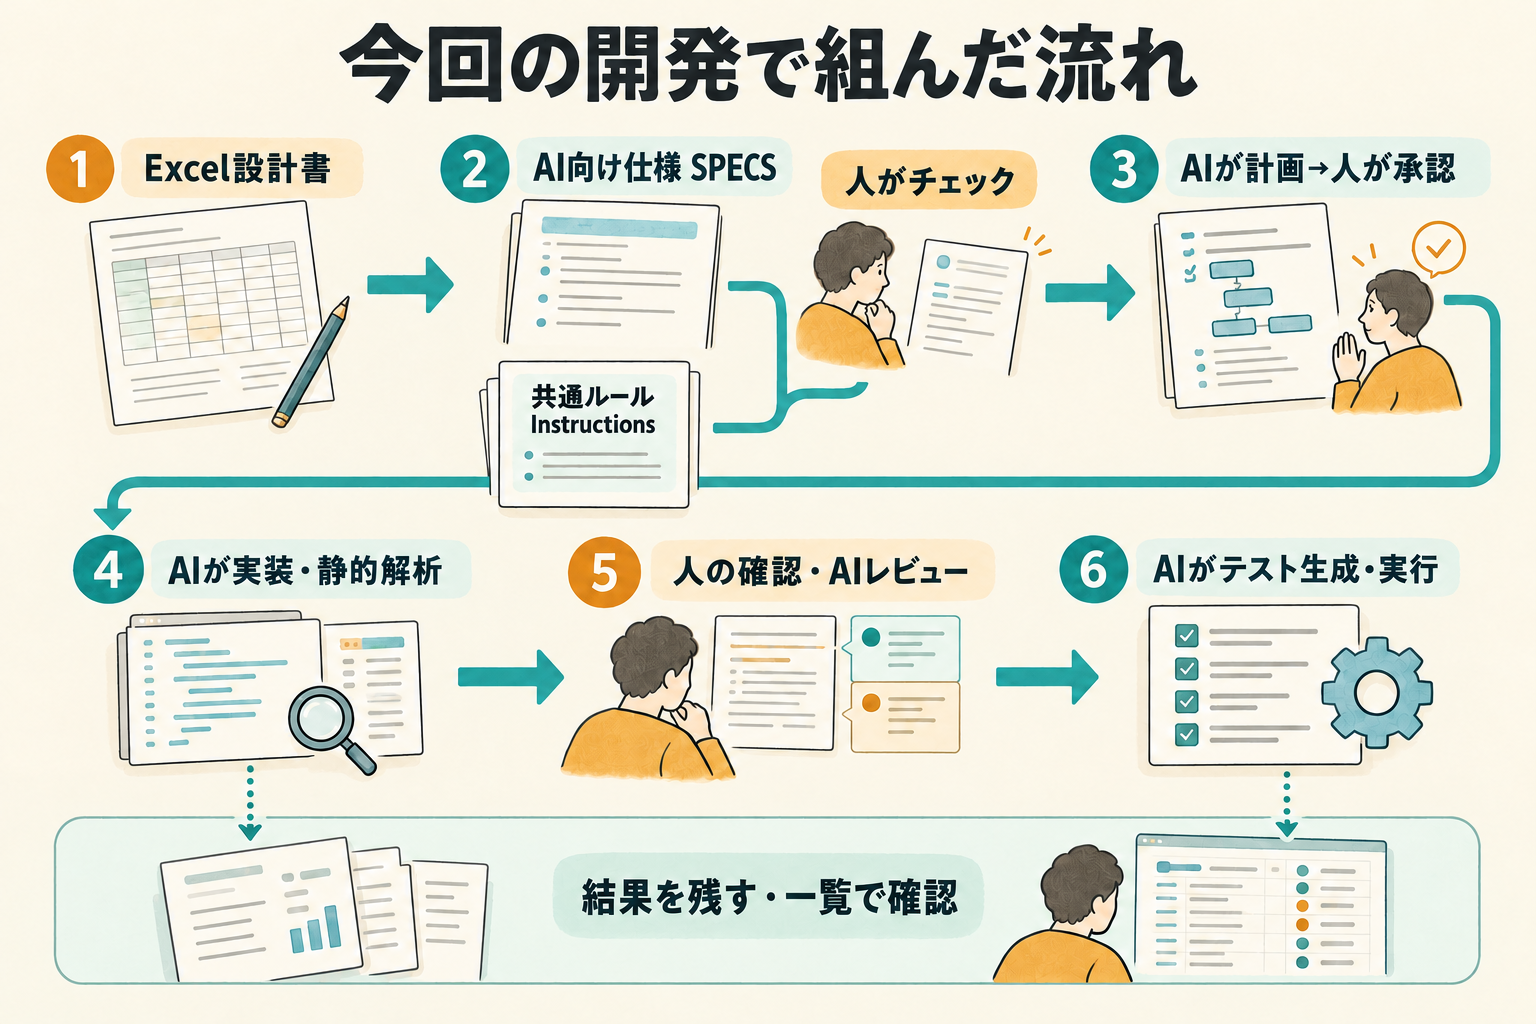
ウォーターフォールなので、まず設計書があります。人が読むためのExcelの設計書です。今回の開発では、これをMicrosoft 365 CopilotでMarkdown(見出しや箇条書きを記号で書くテキスト形式の文書)に変換して、GitHub CopilotのAIエージェントが参照する仕様ファイルにしました。この現場ではこれをSPECSと呼んでいて、製品の標準機能や公式の規格ではなく、あくまで現場での呼び名です。人向けの設計書はそのまま残して、AIに渡す入力を別に用意した形です。
SPECSを作ったら、実装に入る前にSPECSチェックで、業務処理やエラー時の挙動などに抜けがないかを確認する手順にしました。設計書自体に業務仕様が欠けていた場合は、人が元の設計書を直し、SPECSを作り直してから実装に反映する方針です。
業務仕様と共通ルールを別々に持たせる
もう一つ用意したのが、GitHub Copilot向けのInstructionsです。ここには共通の設計ルールや、ログ、例外処理、データの扱いなど、実装の仕方が何通りもあり得る部分について、この開発ではどれを採用するかを書きました。一般的なベストプラクティス集というより、この開発での選択を揃えるためのファイルです。業務仕様はSPECS、共通の実装ルールはInstructions、と役割を分けました。
運用の途中で、ある命名規約の取り違えが起きたことがありました。それを受けて、Instructionsの書き方をより具体的にしています。また、ルールと矛盾していたサンプルコードも修正しました。
Anthropicの記事でいえば、Instructionsの役割はCLAUDE.mdに近いと思います。指摘が続いたら指示ファイルのほうを直すという記事の話と、取り違えを受けてInstructionsを直したのも、方向としては近いです。
実装とテストを分けて、間に人の確認を挟んだ
確認は三段階で組み込みました。AIに渡す前のSPECSチェック、AIが作ったものを人が確認する段階、そしてPRでのチームレビューです。
最初はコード生成からテストまでを一括でエージェントに任せていました。ところが、実装の問題がテストの段階で出てきて、エージェントがそこで修正と再テストを繰り返す状態になっていたんです。そこで実装とテストを分けて、間に人の確認を挟む手順に変えました。
見直した後の流れはこうです。
- AIに実装計画を出させて、人が承認する
- AIがコード生成、セルフチェック、静的解析(プログラムを動かさずにコードを検査する方法)まで進め、結果を出力したところで止まる
- 開発者が結果を確認して修正する。AIレビューで、Instructionsを守れているかも確認する
- そのあとでテストの生成と実行に進み、必要な修正をする
この中で、定型的なルールの確認はAIに任せて、人は業務仕様の確認に集中する分担にしました。一方で、静的解析の単純な違反などは開発者が直接直しました。当時の環境と作業の手間を見て、AIに任せるか人が直すかを決めた形です。
AIに実行結果を出させてから先へ進むという点は、Claude Codeチームの「できたと言うのではなく出力を見せる」と同じ考え方だと思います。修正と再テストの繰り返しも、記事にあるレビューの往復が収束しない話と近いです。Claude Codeチームは往復の上限と差分だけの再レビューで収束させていて、僕の現場では工程を分けて間に人の確認を入れた、という違いがあります。
何をテストしたかを、後から追える形で残す
品質の記録もInstructionsに組み込みました。テストの実行結果や静的解析の結果を所定の場所に残す手順にして、ツールの出力をCSVに変換するスクリプトを用意しました。テストケースの日本語の説明も一覧にして、Excelで確認できるようにしています。開発の細かいところを知らない管理側の人でも、何をテストしたのかを追えるようにするためです。ここで一覧にしたのはテストケースの説明で、実際の実行結果や合否とは別の情報になります。
ただ、記録があれば品質が見えるかというと、そう単純でもありませんでした。後の結合試験で、DBアクセス処理のテストが抜けていたことが見つかったんです。単体テストの実行結果やカバレッジの指標だけでは気づけませんでした。カバレッジの計測対象に現れない処理は、テストがあるかどうかを指標からは確認できなかった、という事例です。指標がどこまでを見ているのかを分かったうえで使わないといけないな、と思っています。
Claude Codeチームの「チェックが何を見逃すか説明できないなら、ちゃんとしたレビューを頼む」という話は、ここにつながると思います。
近いのは考え方で、やり方はかなり違う
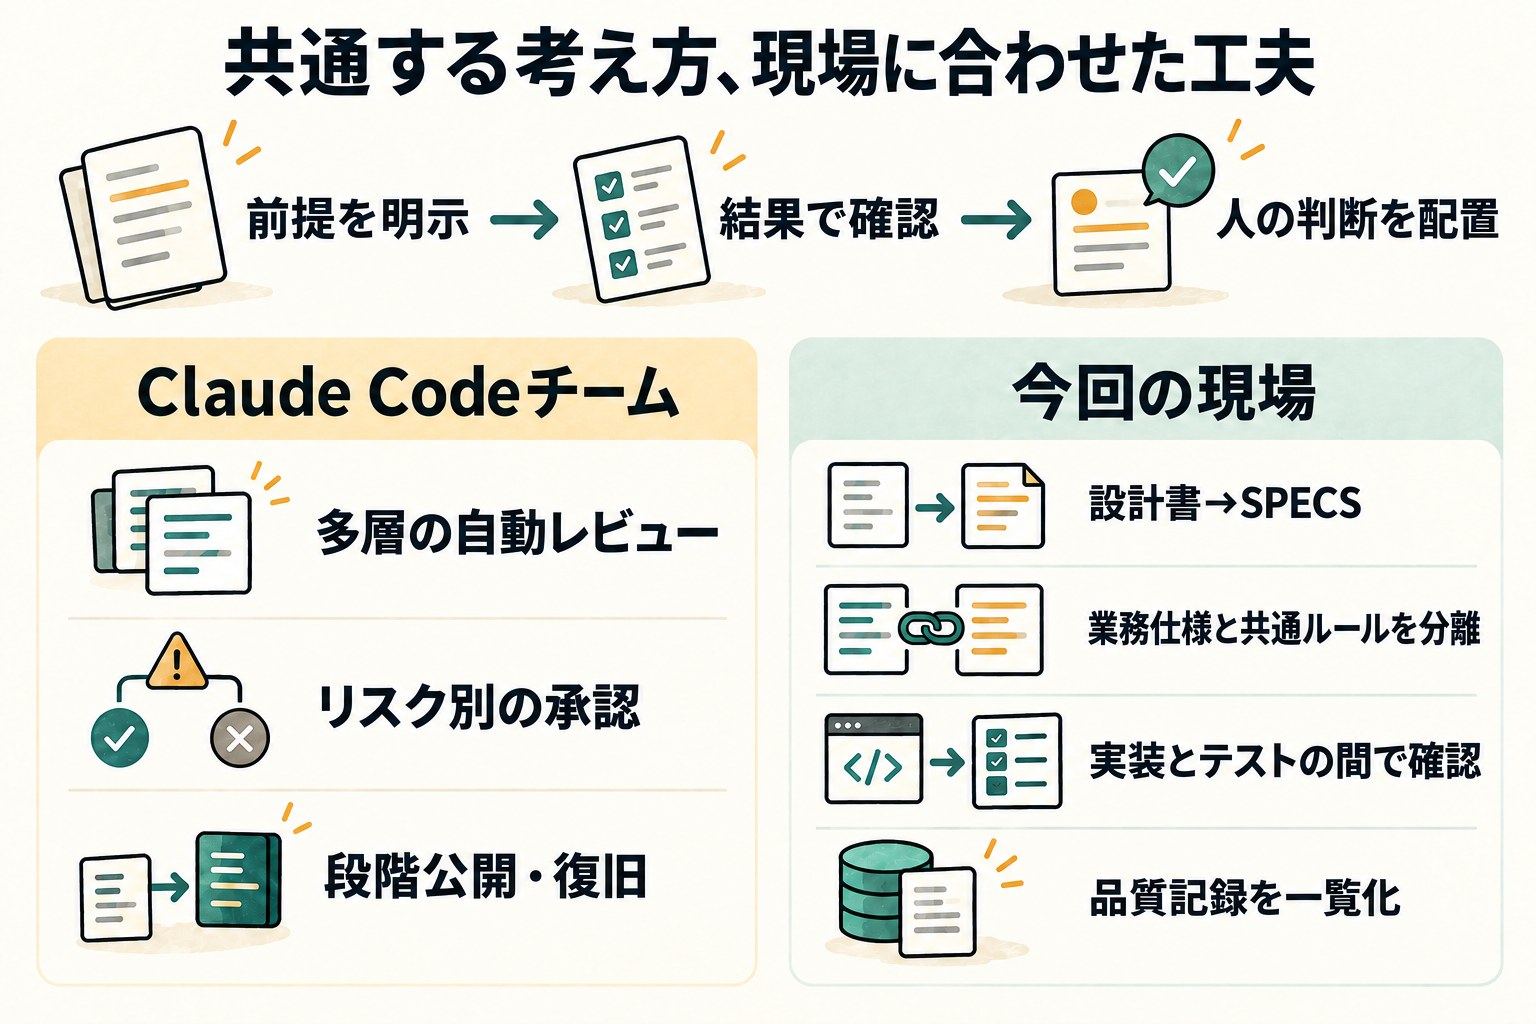
並べてみると、Anthropicの記事と僕の現場で近いのは考え方の部分です。AIに渡す前提を文章で明示して、問題が出たらルールや指示のほうを直す。AIには結果を出させてから人が判断する。人の手は業務仕様のような判断が要るところに回す。確認は一か所に頼らず、何段階かに分ける。
一方で、やり方はかなり違います。Claude Codeチームには、リスク分類による承認の振り分け、低リスク変更の自動マージ、フラグや段階公開による素早い取り消し、障害を元にした毎日の評価があります。今回紹介した手順は、そこまでの仕組みではありません。ウォーターフォールで設計書が先にある分、その設計書をAIが読める入力に変えるところと、工程の区切りで人が確認するところに手をかけた、というのがこの現場向けの工夫です。
それと、人のレビューの負荷は残りました。実装の出力が増えるにつれて、SPECS、コード、テスト、結果のレビュー依頼が人に集中して、そこがボトルネックになったんです。AIレビューを入れても、人がソースや業務仕様を確認する負荷は残りました。WBS(作業を分解した計画表)でレビュー期間に余裕を持たせましたが、それで解消したとは言えないです。
Claude Codeチームが人の時間そのものを測って、取り消しや障害の率と並べて見ているのは、たぶんこの部分をどう減らすかという話なんだと思います。当時は、人のレビューに残る負荷をどう減らすかが次の課題として残りました。
まとめ
Anthropicの記事で紹介されていたのは、人の時間と注意をどこに使うかを基準に、自動チェックと人の判断を何層にも重ねるClaude Codeチームのレビューでした。僕の現場とはやり方がかなり違いますが、AIに渡す前提を文章で明示すること、AIに結果を出させてから人が判断すること、人の確認を判断が要るところに回すことは、考え方として共通していると思います。
その考え方を、ウォーターフォールの新規開発に合わせて今回の開発で組んだのが次の部分です。
- 人向けのExcel設計書から、AIが参照するSPECSをMarkdownで作る
- 業務仕様はSPECS、共通の実装ルールはInstructionsに分けて持たせる
- 実装とテストを分けて、間に人の確認を挟む
- テストや静的解析の結果を残し、何をテストしたかをExcelで追えるようにする
人のレビューの負荷は当時の課題として残りましたが、設計書が先にある開発でも、AIに渡す入力と人が確認する位置を決めて、AI駆動開発の流れを工程の中に組み込めました。