どうもTORAです。
以前、Nano Banana Proで漫画を作っていました。そのとき本当に大変だったのが、当たりのコマやページを引くまでの生成です。
そこへ、GoogleからNano Banana 2.1が出ました。2026年10月6日にGemini APIで一般提供が始まっています(Gemini APIの変更履歴)。今回は公式の資料と作例を見ながら、2.1で何がどう変わったのかを紹介して、僕が苦労していたところがどうなりそうかを考えてみます。僕はまだ2.1を使っていません。なので、ここに書く「良くなりそう」は全部、公式の発表を読んだうえでの期待です。
当たりのコマを引くまでが長かった
当時のやり方を少し書いておきます。キャラクターがコマごとに別人にならないように、参照画像をいくつも渡していました。それとは別に、構図を伝えるためのネーム画像も用意しました。ネームというのは、コマ割りや人物の配置を決めるラフな下描きです。キャラの見た目は参照画像、構図はネーム、と役割を分けて渡して、プロンプトもかなり工夫しました。描き込みの多いネームだと絵柄のほうまで引っ張られてしまったので、最後は超ラフなものに削っています。
それでも、思ったようなコマはなかなか出てこないんです。参照画像でキャラの一貫性を保てたとしても、狙ったコマにはならない。だから何枚も生成して、良いコマが出たらCanvaで合成し、気になるところは部分的に直して、日本語のセリフは自分で手入力していました。
APIは使った分だけ払う従量課金なので、外れた画像にもちゃんと料金がかかります。当たりが出るまで生成すればするほどAPIの料金がかさんで、お金がめっちゃかかったんですよ。手間ももちろんあったんですが、僕が一番気になっているのは、この大変だったところが2.1で変わるのか、今までと変わらないのか、です。
2.1で何が変わったのか
名前だけだと分かりにくいんですが、2.1はProの後継ではありません。Nano Banana 2(Gemini 3.1 Flash Image)のアップデートです。Gemini APIのモデル説明では、Flashクラスの速さとコスト効率はそのままに、画質、プロンプトへの忠実さ、何度もやり取りしながら編集するときの人物の一貫性、画像内の文字の描き方が大きく良くなった、とされています。
DeepMindのNano Banana 2.1の紹介ページでは、以前のNano Bananaモデルを上回った点として、ビジュアルデザイン、マスクを使った編集、被写体の一貫性、より自然な見た目の画像が挙がっています。
出力は1K・2K・4Kに対応し、最大14枚の参照画像を使えます。検索した情報や画像を生成に反映する機能もあります。今回の修正として具体的に書かれているものだと、たとえば1:4や8:1のような極端に横長・縦長の比率を2Kや4Kで出したとき、同じ模様が繰り返し並んでしまう問題が直っています。
APIでは、Thinking、つまり生成の前にモデルに考えさせる設定の強さを、minimal、medium(既定)、highから選べます。考える量を増やせば品質に期待できる一方で、思考の分も出力として料金がかかりますし、時間も延びそうです。全部highにすればいいという話ではなく、品質と速さと費用の兼ね合いで選ぶ設定ですね。
試すなら、Google AI Studioから選べるほか、Gemini APIではモデルIDにgemini-nano-banana-2.1を指定して使います。モデルカードによると、GeminiアプリやGoogle Flowなどでも提供されています。ただ、僕が昔使っていたのはAPIなので、この記事ではAPIの話を中心にします。
Proを上回ったのは、僕がやっていたことに近い項目
同じ日に公開されたモデルカードには、Googleが人による並べ比べで評価した結果が載っています。画像編集の比較では、ラフな描き込みやマスクを使う編集、複数の参照画像からの編集、複数キャラクターの一貫性で、2.1のThinking設定がProを上回っていました。どれも、僕が当時やっていたことに近い項目です。
ただ、これは人がどちらを好んだかを比べたスコアで、成功率ではありません。漫画のコマが一発で決まる割合や、ページ完成までに何枚生成したかを測ったものでもないです。紹介ページの作例も、Proと同じ条件で並べた比較ではなく、2.1でうまくいった例として載っているものです。そのうえで、気になった作例を3つ見てみます。
公式作例:Mask-based editing
引用:Google DeepMind「Nano Banana 2.1」、「Introducing Nano Banana 2.1」節(Mask-based editing)の公式作例(出典)。
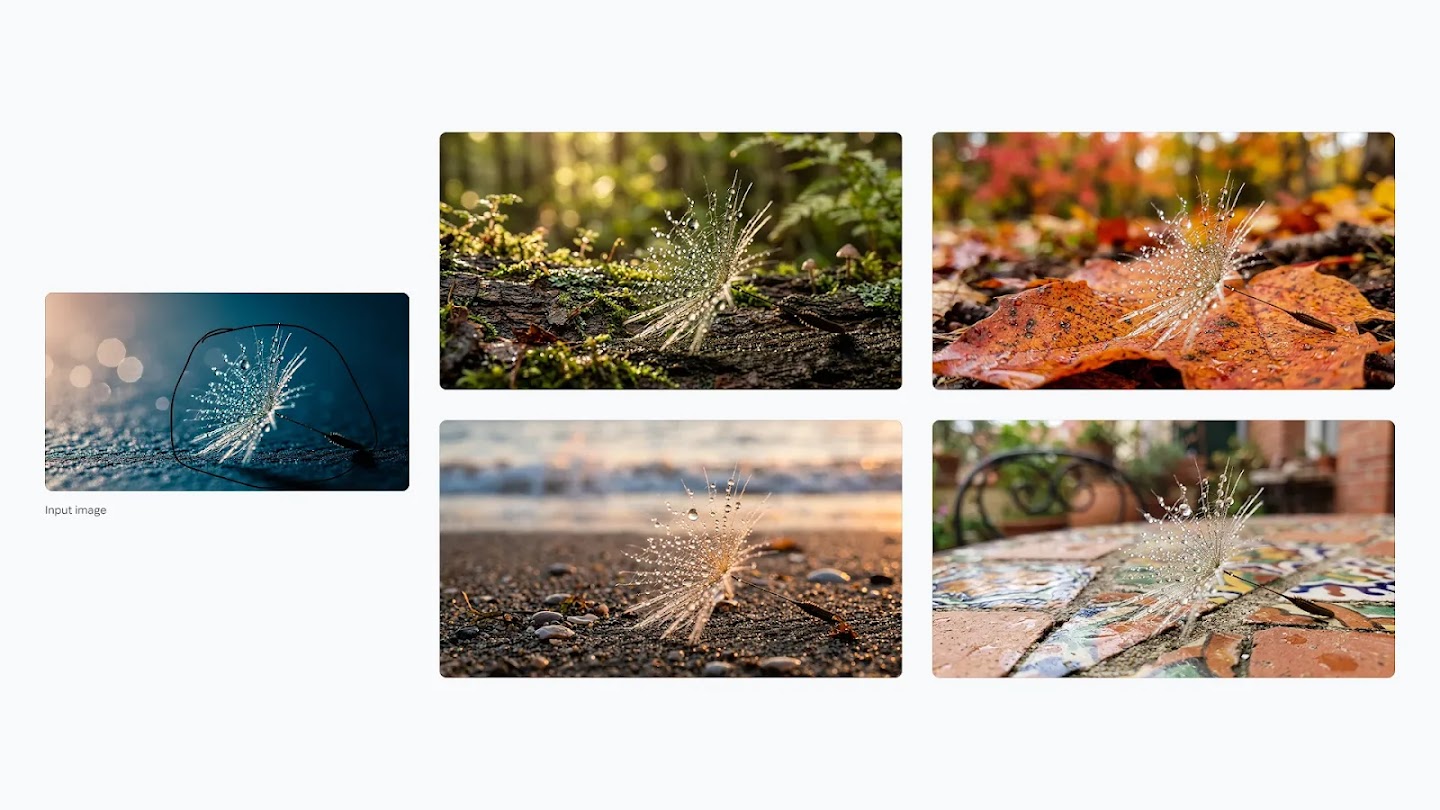
1つ目は「Mask-based editing」の作例です。左の入力画像では、水滴のついた小さな綿毛のようなものが黒い線で囲ってあります。右の4枚は、それを苔の生えた地面、紅葉した落ち葉の上、海辺の砂地、タイル張りのテーブルといった、まったく違う場所に置いたものです。プロンプトは、囲ったものの大きさと位置は変えずに環境だけ変えて、という内容でした。
これを見て思い出したのが、超ラフなネームで配置を伝えていたときのことです。線で「ここにこれ」と示した指示に前より沿ってくれるなら、ネームで伝えた構図に近いコマが出やすくなるかもしれません。部分的な修正も、変えたい範囲を示して頼めるなら、合成や手直しが少し楽になりそうです。ただ、評価も作例も、描き込みで範囲を指定して既存の画像を編集するものです。ネームからコマを新しく起こす使い方を測ったわけではないので、そこは僕の期待の部分です。それに、モデルカードには、ラフやマスクを使った編集で指示が一部しか反映されなかったり、描いた線が出力に残ったりすることがある、と書かれています。左右を取り違えることや、まれに元画像のポーズがそのまま残ることもあるそうで、どれも狙ったコマを出したいときに引っかかりそうなところです。
公式作例:Subject consistency
引用:Google DeepMind「Nano Banana 2.1」、「Introducing Nano Banana 2.1」節(Subject consistency)の公式作例(出典)。
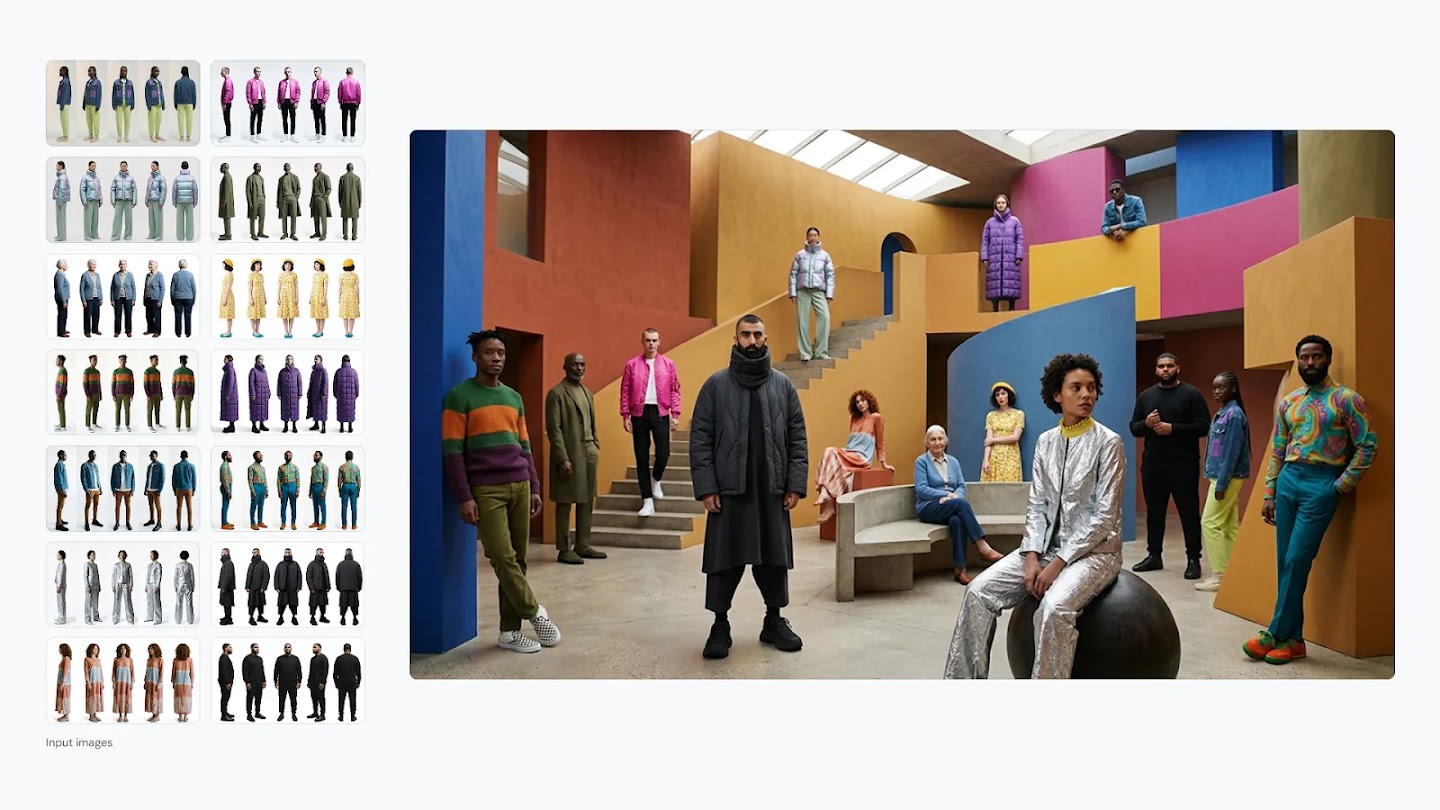
2つ目は「Subject consistency」です。左には、別々の人物をいくつかの角度から写した参照画像がずらっと並んでいて、右はその人たちを色の強い立体的なセットに集めたファッション写真です。服や髪型を見比べると、参照の人物を拾って一枚にまとめているのが分かります。手前に立つ人もいれば、階段の上や奥の通路にいる人もいて、遠近をつけて配置されています。
僕が気になるのは、人物の見た目を保ったまま、こちらで用意したネームの配置やポーズにどれくらい合わせられるかです。複数参照の編集と指示追従が良くなっているなら、引き直しも少し減りそうなんですよね。人物の見た目が完全には一致しない場合があることは、モデルカードにも残っています。
公式作例:Better visual design
引用:Google DeepMind「Nano Banana 2.1」、「Introducing Nano Banana 2.1」節(Better visual design)の公式作例(出典)。
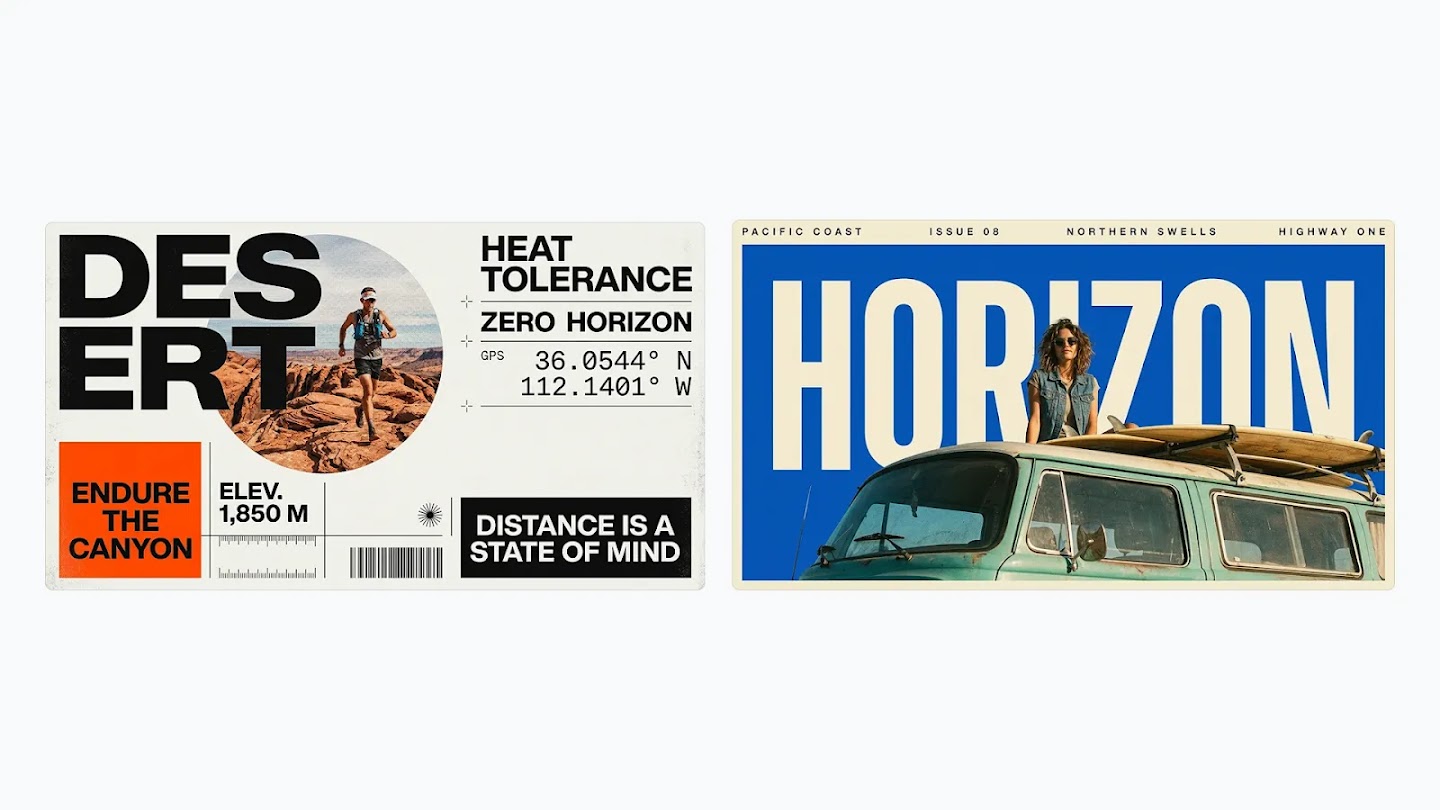
3つ目は「Better visual design」の作例で、ポスターが2枚並んでいます。左は、トレイルランナーの写真を丸く切り抜いて、大きな見出し文字や標高、座標、バーコードといった細かい要素と組み合わせたもの。右は、青い背景に大きく「HORIZON」と入れて、その文字に人物と車が重なるように置いたものです。左右は旧版と新版の比較ではなく、どちらも2.1の作例です。
文字と写真の配置はかなりきれいです。ただ、この作例は英語なんですよね。日本語のセリフや小さな書き文字まで任せられるかは、ここからは分かりません。モデルカードにも、小さい文字や長い文章はまだ苦手と書かれているので、セリフの手入力はしばらく残るんじゃないかなと思っています。
2.1になっても従量課金
料金も見てみました(Gemini APIの料金ページ、2026年10月8日時点)。2.1もAPIは従量課金で、無料枠はありません。
2Kの画像1枚あたりの出力料金で比べると、Proが0.134ドル、2.1が0.0504ドルです。画像を出す部分だけで見れば、4割弱まで下がっています。
ただ、これは画像出力の部分だけの話です。プロンプトや参照画像の入力、Thinkingの思考の部分は別に料金がかかります。参照画像をたくさん渡す使い方だと入力も増えますし、Thinkingで使った量に応じた料金も加わります。外れた画像にも料金がかかる仕組みも同じです。完成までの料金は、生成枚数に加え、入力や思考に使う量でも変わるので、この比率でそのまま下がるとは言えません。単価が下がっても、当たりが出るまで何枚も引き直すならそのぶん積み上がっていきます。逆に、単価が下がったうえで引き直しの回数も減るなら、かなり楽になると思います。
だから僕が知りたいのは、きれいな一枚が出るかどうかより、欲しいページにたどり着くまでに何回引き直して、いくらかかるのか、なんですよね。公式の発表を読む限り、期待できそうな材料はけっこうあります。でも、昔みたいに超ラフなネームと参照画像を渡したとき、どれくらい少ない引き直しでページを作れるのか。そこがどれくらい変わったのか、気になっています。