どうもTORAです。
今のプロジェクトで、ちょうど性能試験をやっています。今回初めて、うちの若手メンバーに性能試験の担当をやってもらっています。いきなり放り投げるんじゃなくて、セオリーというか進め方を説明しながら一緒に進めているところです。
自分でも方法論を改めて人に説明しているタイミングなので、思い出しがてら、ここでも話してみます。
性能試験と一概に言っても、いろんなパターンがあります。大きく分けると画面系、API、バッチあたり。僕が今やっているのはバッチのほうです。エンタープライズのそれなりの規模のシステム開発だと、大量のトランザクションデータをバッチで処理する、というのがよくあるんですよね。
朝5時までに終わればいいのか
それなりの規模になってくると、性能要件というものがあります。エンドユーザー側から出されていることが多いです。そこまでの規模じゃなければ、作る側の自分たちで「このくらいの性能があれば業務として回るだろう」というところを決めます。どちらにしても、これを満たせば性能としてOK、というゴールの基準はある程度決まっています。
決まり方のレベル感は様々で、かなり厳密なこともあれば、大枠このくらい、という定義しかないこともあります。なので最初は、元ネタになる情報から性能のゴール地点を見定めて、はっきりさせるところからスタートします。
今やっているようなバッチだと、要件は「夜間のこの一連の処理が、朝の何時までに完了していること」みたいな形だったりします。仮に、この流れのバッチがスタートできるのが夜中の12時を回ってからで、朝5時までに終わっていないといけないとします。そうすると、このバッチとこのバッチとこのバッチ、という流れ全部でトータル5時間以内に収まればいい、ということになりますよね。
なので性能試験でも、この例ならバッチの流れ全体が5時間に収まるかを確かめます。ちなみに、ここから出てくる時間や件数は、どれも説明のための例です。
空っぽのデータベースで処理するわけじゃない
要件と目標値が決まったら、次はどのくらいのデータ量を扱うのかという話になります。バッチなら、日次で処理するデータが何百万件なのか、何千万件なのか。オンラインの処理でも、データベースにどれだけ蓄積されているかは結局関係してきます。
お客さんが現状の件数を出してくれていることもあります。今の業務では毎日何百万件処理しています、と。ただ今後はサービスを拡充して利用者を増やしていくので、5年後にはこれの倍になります、みたいに事業の目標も絡んできます。そうなると「5年後の量を処理しても、何時間以内に終わるようにしてください」という要件になったりするわけです。
ここまで来ると、前提になるデータが見えてきます。このマスターには何十万件くらい入っていて、このバッチが日次で処理するトランザクションは何百万件で、という具合です。
もう一つ考えなきゃいけないのが蓄積データです。毎日まっさらな状態から処理するわけではなく、普通はデータベースに過去のデータが残っていますよね。例えば毎日700万件処理するのが目標で、そのテーブルは1年間データを保持する設計だとします。そうすると、700万件の365日分が溜まった状態でも、バッチは性能を満たさなきゃいけない。じゃあその蓄積データも性能測定のときに入れておかなきゃダメだよね、という話になります。
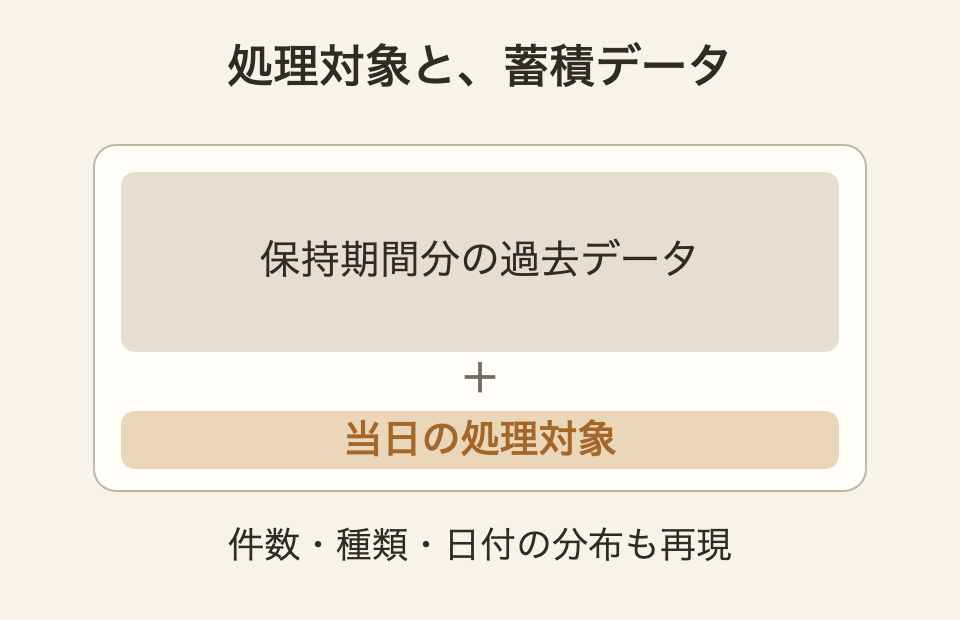
どこに何をどれだけ準備するかという前提データのボリュームは、この段階で見繕っておきます。
データは適当に入れるだけじゃダメで
ボリュームが見えてきたら、次は性能試験のためのデータ設計です。件数がそろっていればいいわけではなくて、本番に準じたバリエーションを意識する必要があります。項目ごとに値が何種類あるか、いわゆるカーディナリティですよね。
僕が扱っているシステムだと、日次のトランザクションデータが大量にあって、そのテーブルは日付でパーティショニングしています。パーティションがちゃんと効果的に動いているかを見なきゃいけないので、さっきの例なら1日700万件ずつ、日ごとに溜まっている状態まで再現します。そこが再現できていないと、パーティションが効いているかどうかを本番の想定条件で確認できないんですよね。対象外の日付まで読みにいっていたら、このデータ量だと時間がかかる原因になります。
インデックスがちゃんと貼られているかも、ここで整えておきます。検索に使う列のインデックスは設計の時点で決まっていることが多いので、それを用意しておく。ただ、貼ってあることと実際に使われて速くなることは別の話なので、そこは後で実行計画と計測で確かめます。
実際の作業としては、だいたい大量データを作るためのツール作りから始まります。1日700万件といっても、いきなり700万件を作るのは大変です。だからまず100件くらいの規模にスケールダウンして、この100件のうち何割は何々系のデータ、何割は何々系、という配分を、リアルな本番の情報をもとに設計するんです。
100件でこういうバランス、と決まったら、それを1000件、1万件、100万件、700万件と増幅させて、性能試験用のデータを作ります。これがよくあるパターンで、セオリー通りかなと思います。
増幅するツールは、データがちゃんと分散される仕組みにしておきます。同じ100件をそのままコピーし続けるだけだと、700万件になっても中身は100件のときと同じ値の繰り返しなんですよね。件数だけじゃなく、値の種類の数や偏り、日付の散らばり、ほかのテーブルとの紐づきまで想定どおりになっているかを見ておきます。
まずは一回やってみる
データが入ったら、まずはプレ走行というか、一回やってみます。どうなるか、何が出るか分からないけど、一旦流してみる。
ただ、流す前に、性能を分析するための情報収集の準備は間違いなくやっておきます。僕は今Javaで作っているので、見るものはだいたいこんな感じです。
- Javaのプロセスの状態
- サーバーのリソース
- データベースのリソース状況
- データベース側の分析(どのSQLが負荷になっているか)
AWSなら、今はCloudWatch Database Insightsみたいなサービスが、データベースの負荷を大きくしているSQLを自動で並べて見せてくれたりします。旧来だと、OracleならDB側の分析ツールでレポートを見たりですね。リソース情報を取るツールが必要なら、シェルとかで作って仕掛けておきます。
それと、プログラムの中に、処理の経過時間をログに出す仕組みをあらかじめ仕込んでおきます。このバッチのこの部分にどれだけ時間がかかったのかが後から追えるので、ボトルネックが探しやすくなります。
本番並みのデータ量でガッツリ流すと、スクラッチ開発で最初にやったときは、大体予想通りには動かないですよね。何十時間経っても終わりませんとか、動いている気配がないのに全然プロセスが終了しませんとか、そういうことが普通に起きます。
200msecって、パッと見ると
そこから問題を切り分けていきます。最初の仕事はボトルネック探しです。ボトルネックっていうのは、要は処理の詰まっているポイントですね。
データ量が大量になると、どうしてもDBからデータを取ってくる部分がボトルネックになりやすい。なので、まず当たりをつけるのは「遅いSQLはどれだろう」というところです。さっきのDatabase Insightsのようなツールを使ったり、必要なら作ったりして、時間のかかっているSQLを探していきます。
一つは、処理対象のデータを取ってくるSQLそのものに何十分もかかっている、というパターン。これはすごく分かりやすいです。
もう一つ見なきゃいけないのが、取ってきた700万件とか1000万件の処理対象データを、一件一件処理していく中身のほうです。処理対象のデータをもとにどこかのマスターを見に行ったり、連番を採番したり。件数分いちいち実行されるものが、どのくらいのスピードで処理できているかもポイントなんですよ。
例えば1000万件のレコードがあって、その1件ごとに200msecかかるSQLの処理があったとします。200msecだけなら大したことないなと思うんですけど、1件ずつ順番に流して、毎回きっちり200msecかかると仮定して単純計算すると、200msec×1000万件で200万秒。時間にすると約556時間です。
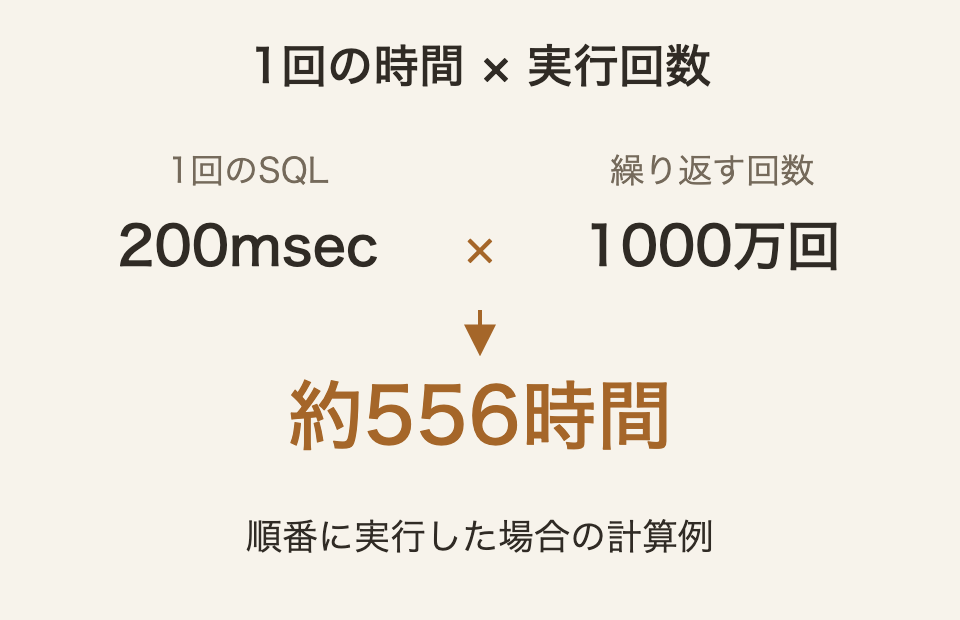
実際は並列化がどれだけできるかにもよるので、バッチの経過時間がそのままこうなる、という話ではありません。並列にすれば待つ時間を縮められることもありますけど、並列化だけでは実行回数自体は減らないし、DBの負荷によっては速くならないこともあります。1件あたりは小さく見えても、件数分やったらちりつもで一体どれだけの時間になるのか。そこを探るのも大事なんですよね。
だいたいデータベース周りは、いろいろとボトルネックを生み出しやすいです。もちろんプログラムの中にもそういう箇所はあったりするので、それも見つけていくしかないですね。
実行計画をちゃんと見て
ボトルネックが見えてきたら、次はそれをどう改善するかを考えます。
データを取得するSQLが遅いなら、まずパーティションプルーニング(検索条件に関係しないパーティションを読み飛ばす仕組み)がちゃんと効いているか、インデックスがちゃんと効いているか、というところから見ていきます。日付でパーティションを切ってあっても、SQLの条件が切り方と対応していないと、関係ないパーティションまで読みにいっちゃうことがあります。
SQLを直すときは、実行計画も見ながらやります。実行計画には、そのSQLをDBがどう実行しようとしているかが出ます。全体を順に読むのかインデックスを使うのか、テーブルをどう結合するのか、それとその見積もりですね。意図したインデックスが使われているかが分かるし、どこがボトルネックになっているかもかなり分かる。それを見ながら対策を取っていくのも、セオリー通りです。
ただ、実行計画に出るコストはあくまで見積もりで、実際にかかった時間そのものではありません。インデックスも、使われたかどうかだけでは良し悪しを決められないです(広い範囲を読むSQLなら、使わないほうが速いこともあるので)。なので実行計画だけで決めつけずに、経過時間のログやDBの負荷の情報と合わせて見ていきます。
件数分の処理が重いほうなら、また別の手を考えます。200msecかかるマスターデータの取得が何千万件分も積み重なっているなら、それを1レコードずつやるんじゃなくて、最初に処理対象データを取ってくるときに一緒にジョインして持ってきちゃえばいいじゃん、とか。ジョインすれば必ず速くなるわけではないし、結合のしかたで件数や結果が変わってしまったら意味がないです。なので、結果が変わっていないかは件数や中身を突き合わせて確認して、速くなったかどうかは対策したあとの計測で確かめます。
性能試験って、手前で見つかったボトルネックが解決しないと次のボトルネックが見えてこない、ということもあるので、結構トライアンドエラーになりがちです。それでも、なるべく遅いSQLとかを探して、ボトルネックになるところをしっかり洗い出してから、それぞれ対策を打っていくのがいいかなと思っています。
改善されているかを見ていく
対策を入れたら、もう一回、同じ条件で再走行します。前回と同じように計測して、リソースも分析します。
ここでいう条件には、データも、実行の設定も、環境も含まれます。そこがずれていると、何のおかげで速くなったのかが分からなくなっちゃうんですよね。キャッシュの状態が違うだけでも、数字は動くことがあります。
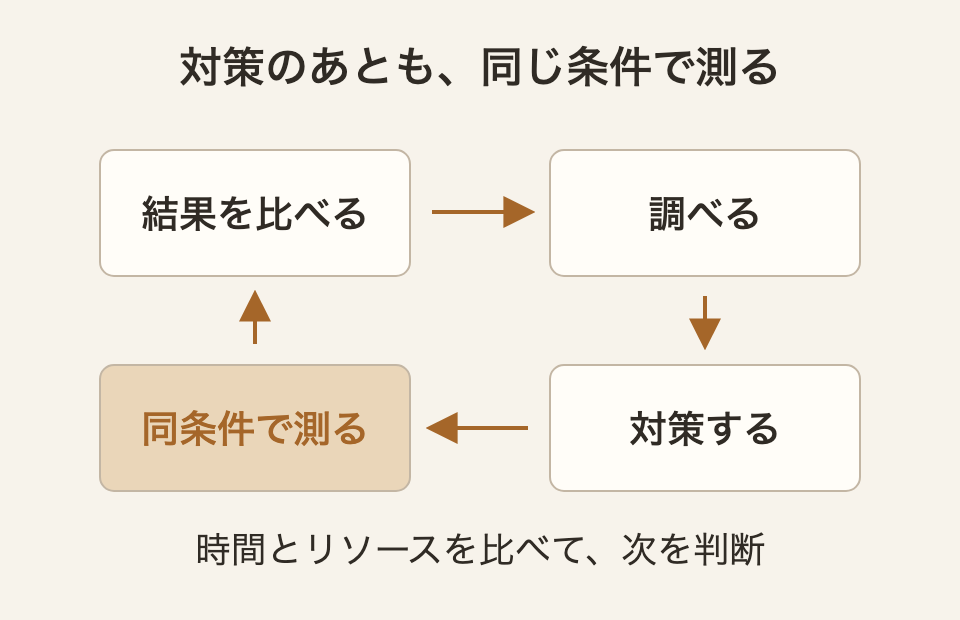
前回の結果と比べて数字がどう変わったかを見て、次のボトルネックが出てきたら、また調べて対策する。これを何周か繰り返していきます。こんな感じで性能試験っていうのをやっていくんですよね。